OCR français / arabe : enjeux et limites
L’OCR multilingue français / arabe ouvre des gains importants, mais demande préparation documentaire, contrôle qualité et validation métier.
24 juin 2026 · JBRTECH
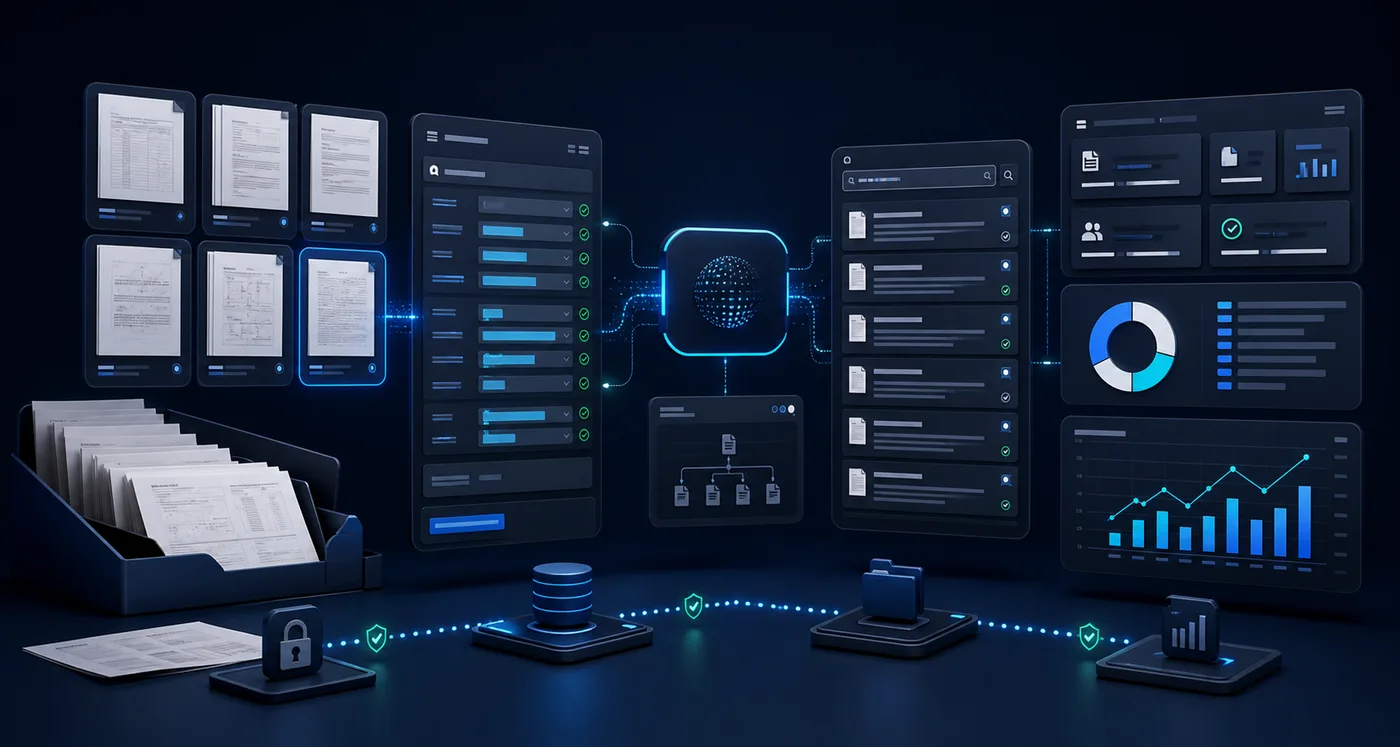
L’OCR transforme des documents scannés ou images en texte exploitable. Dans les organisations francophones et arabophones, la qualité dépend fortement des supports.
Les facteurs de qualité
La résolution, l’orientation, la mise en page, les tampons, signatures, tableaux et documents manuscrits influencent directement le résultat.
Un bon projet OCR ne se limite pas au choix d’un moteur. Il inclut des règles de préparation, des contrôles et des seuils d’acceptation.
Extraction ou simple texte ?
Reconnaître le texte est une première étape. Le vrai gain apparaît lorsqu’on extrait les champs utiles : numéro de dossier, date, montant, partie, référence ou statut.
Cette extraction doit être testée sur des documents réels.
Contrôle humain
Certains contextes exigent une validation humaine, surtout lorsque les erreurs peuvent avoir un impact juridique, financier ou administratif.
L’automatisation doit donc prévoir des files de contrôle et des exceptions.
De l’archive au workflow
Une fois indexé, le document peut alimenter un moteur de recherche, un assistant IA, un portail ou un workflow de traitement.